数据库与数据仓库
本章介绍数据库型数据源的通用创建流程,以及版本、连接方式和云数据库配置的差异。支持范围见数据源总览。Hive 还支持 Metastore 连接;MaxCompute 使用项目和云账号信息配置。
选择类型与版本
在“数据源”中点击“新建数据源”,选择目标数据库。需要选择版本或兼容模式的类型如下:
| 数据源 | 可选版本或模式 | 配置要点 |
|---|---|---|
| Apache Hive | Hive 2.x、Hive 3.x;Metastore 连接、JDBC 连接 | 地址、端口和认证方式需对应所选服务 |
| MySQL | MySQL 5.x、MySQL 8.x | 按目标服务器版本选择 |
| Microsoft SQL Server | MSSQL、MSSQL 2022 | SQL Server 2022 使用对应选项 |
| OceanBase | MySQL、Oracle | 与目标租户的兼容模式一致 |
| AnalyticDB | MySQL、PostgreSQL | 两类实例分别使用对应连接方式 |
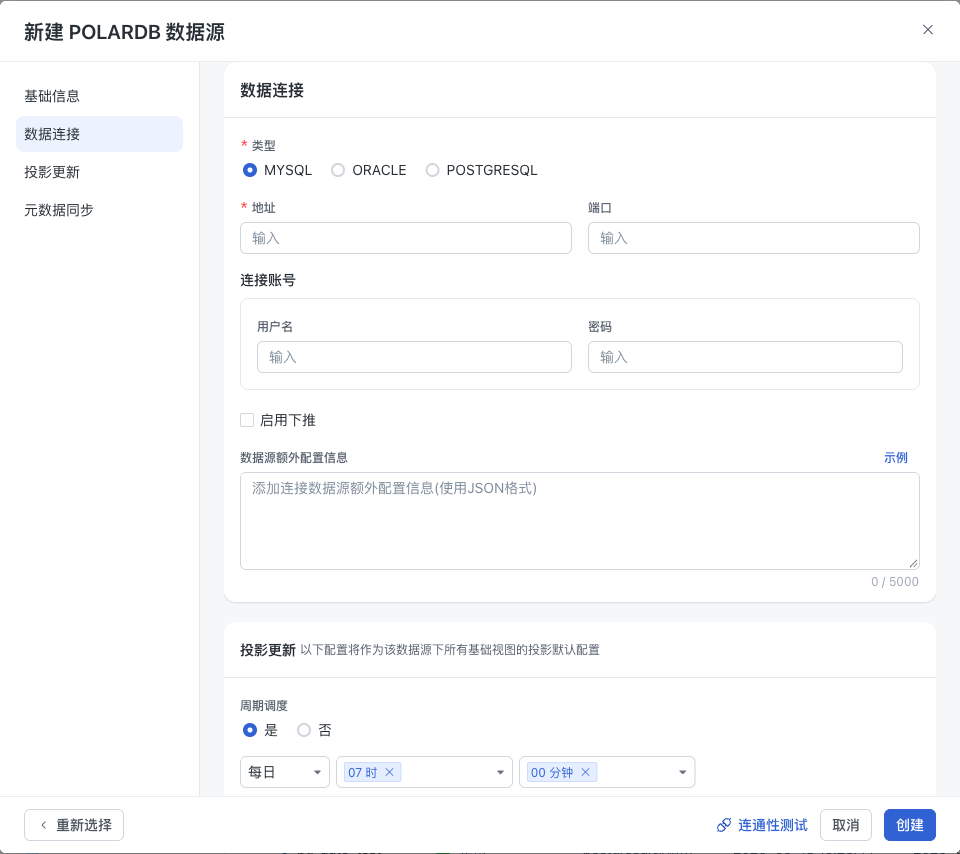
| PolarDB | MySQL、Oracle、PostgreSQL | 与目标集群兼容模式一致 |
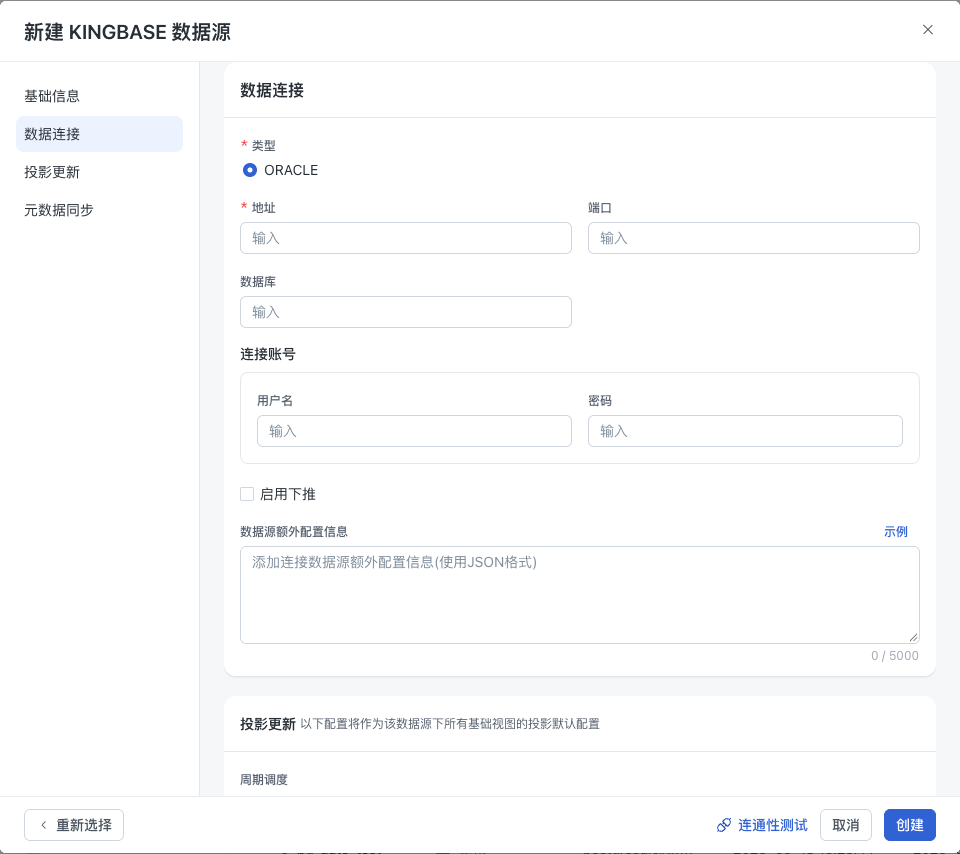
| Kingbase(人大金仓) | Oracle | 当前入口提供 Oracle 兼容模式 |
其他入口包括 PostgreSQL、Oracle、GaussDB、ClickHouse、Dameng、SAP HANA、Apache Doris、StarRocks、TiDB、Impala、Databricks、AIR、Athena、Vertica、Snowflake、Db2、Trino、ArgoDB、Huawei DWS、openGauss、InterSystems 和 MaxCompute。
通用连接步骤
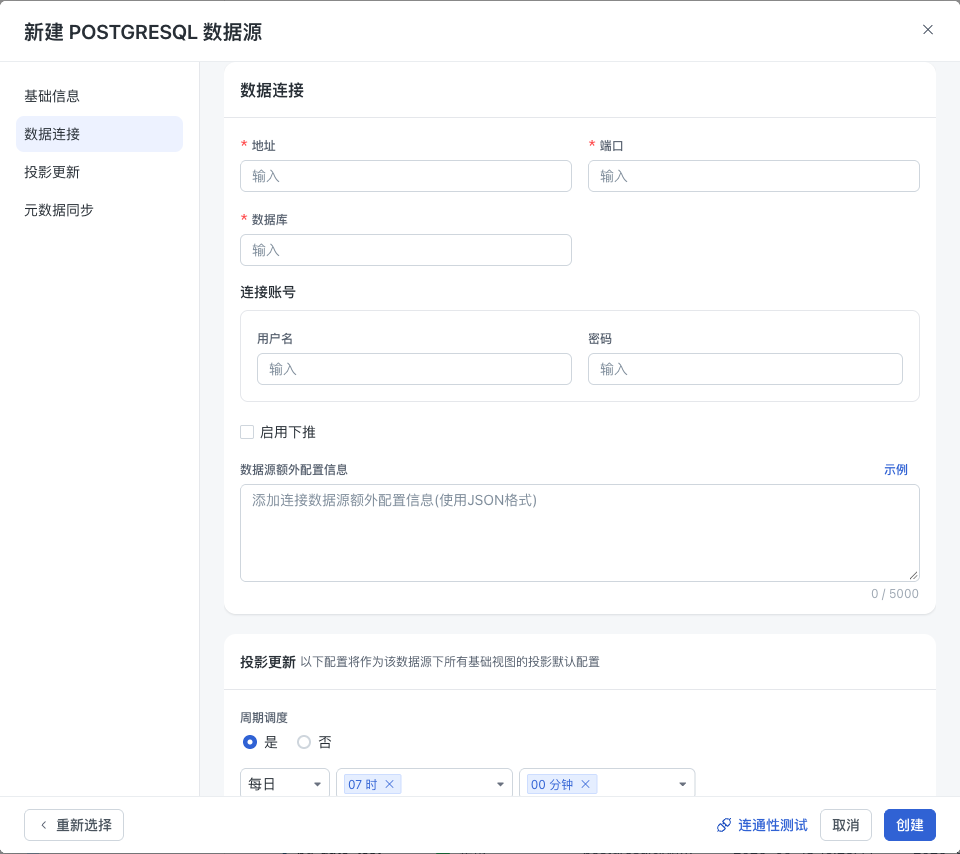
以 PostgreSQL 为例:
- 选择“PostgreSQL”,填写数据源名称和描述。
- 切换到“数据连接”,填写地址、端口、数据库以及连接账号。
- 按需配置“启用下推”和“数据源额外配置信息”。
- 配置投影更新和元数据同步,点击“连通性测试”。
- 测试通过后点击“创建”,等待元数据采集,展开库表并检查字段。
| 配置项 | 说明 |
|---|---|
| 地址 | 目标数据库或查询服务的连接地址 |
| 端口 | 目标服务实际监听端口;仅在页面显示时填写 |
| 数据库 | 目标数据库名称;不同类型可能表示数据库、服务名或云项目,按该类型说明填写 |
| 连接账号 | 有元数据读取、数据查询权限的用户名与密码,或该数据源要求的云访问凭据 |
| 启用下推 | 允许将支持的查询计算交给源数据库执行;也是投影下推写入的前提,仍需配置写账号,见下文 |
| 数据源额外配置信息 | 使用 JSON 补充连接参数,详见数据源额外配置 |
不要将某一数据库的端口、库名规则或认证方式直接套用到其他类型。Athena、Snowflake、Databricks 等服务应根据各自连接表单准备信息。
Hive
先选择 Hive 2.x 或 3.x,再选择连接方式。Metastore 地址与 JDBC 服务地址承担不同用途,应分别使用部署时提供的连接信息。
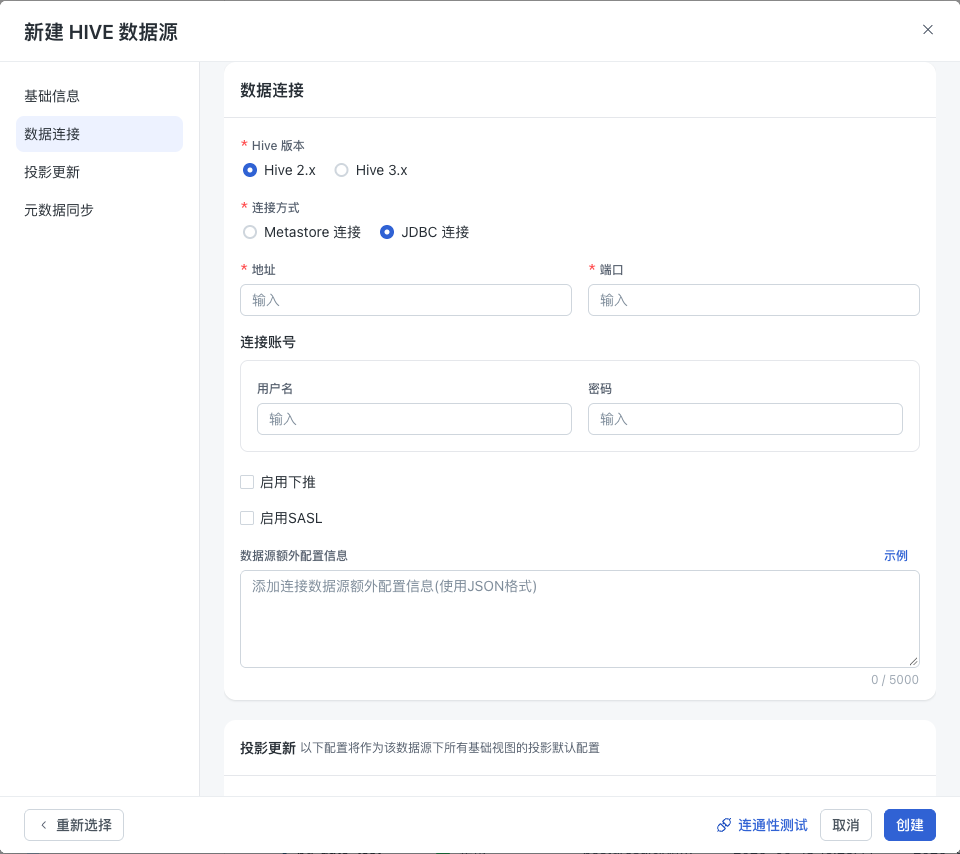
按目标环境配置连接账号及认证选项。使用 Kerberos 等认证时,准备页面要求的 Principal 和认证文件;不要把 Metastore 端口当作 JDBC 端口。创建后检查目标数据库和表是否成功采集。
MaxCompute
选择“MaxCompute”,按下表将云项目的连接信息填入页面:
| 页面字段 | 填写内容 |
|---|---|
| 地址 | MaxCompute 服务 Endpoint |
| 数据库 | 目标 Project 名称 |
| 用户名 | 有权访问该 Project 的 AccessKey ID |
| 密码 | 对应的 AccessKey Secret |
| 启用 Schema | 根据目标 Project 是否使用 Schema 选择;选择后按 Schema 组织库表元数据 |
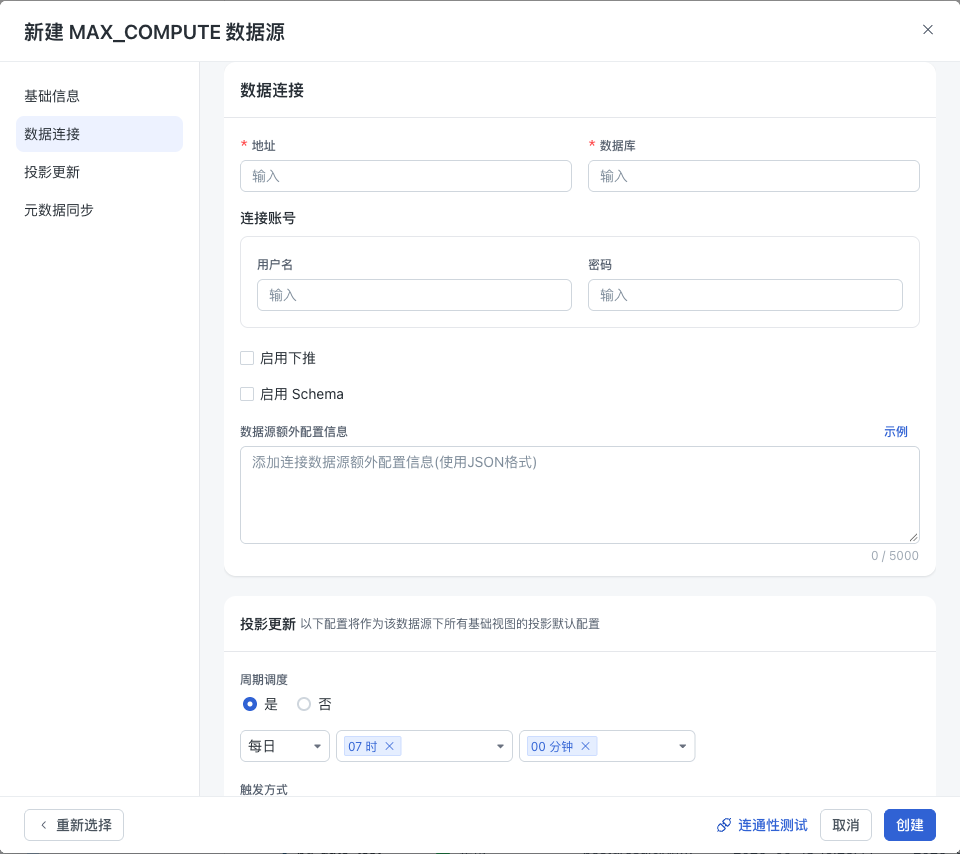
确认 Endpoint 与项目所在区域一致,连接账号具有读取目标项目元数据和数据的权限。创建后检查项目下的目录和表,再执行小范围查询。
AnalyticDB
选择“AnalyticDB”,在“AnalyticDB 类型”中选择 MySQL 或 PostgreSQL。填写实例地址、端口、连接账号,以及所选模式显示的数据库等字段。
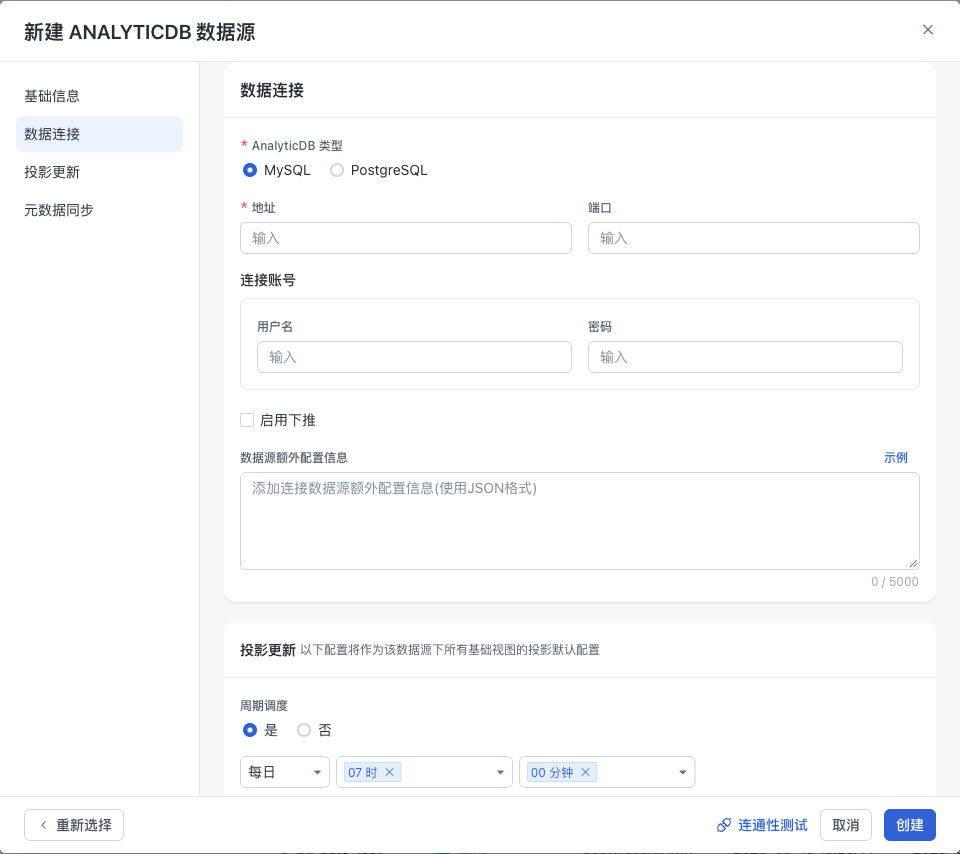
实例类型决定连接方式。切换类型后,重新核对页面中的端口、数据库和认证信息,再执行连通性测试。
PolarDB
选择“PolarDB”,按目标集群选择 MYSQL、ORACLE 或 POSTGRESQL。填写该模式的地址、端口、数据库和连接账号;字段是否显示及是否必填以当前模式的表单为准。
Kingbase(人大金仓)
选择“Kingbase”。当前“类型”提供 ORACLE 选项,对应人大金仓 Oracle 兼容模式;填写地址、端口、数据库和连接账号后测试连接。
为投影下推写入配置 catalog
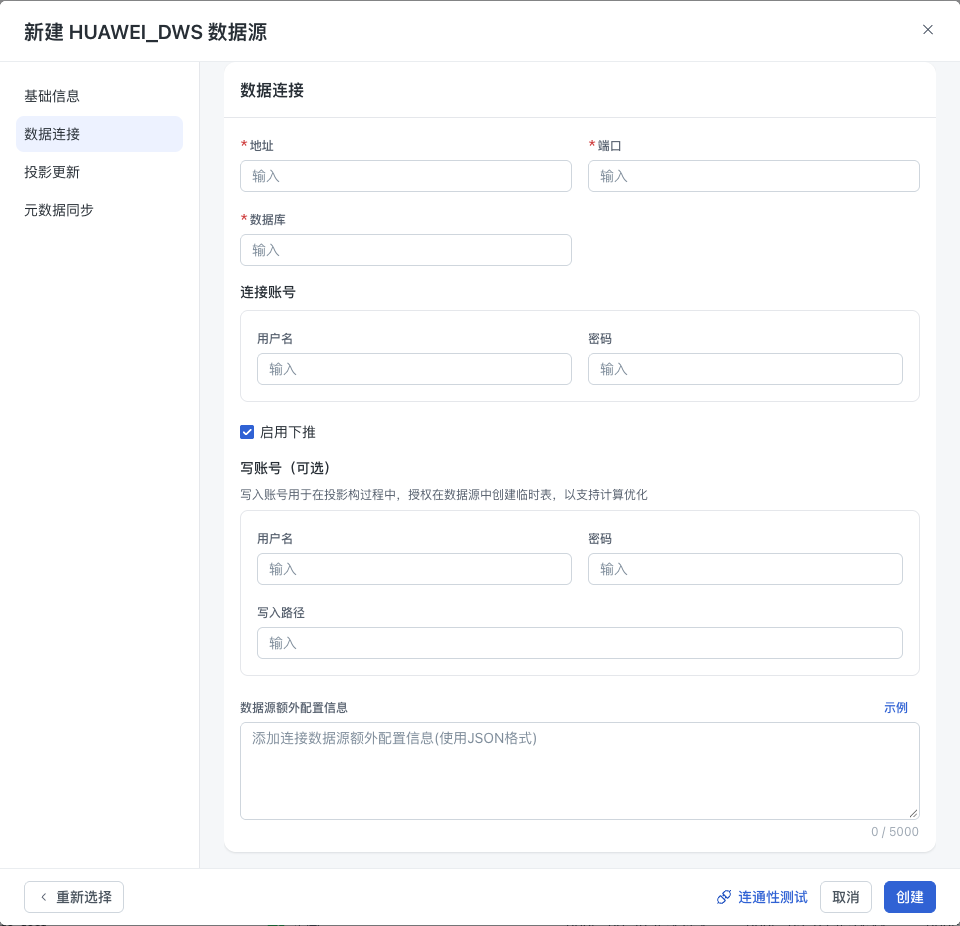
逻辑视图的投影可以通过“下推写入”加快构建:先在源数据库中计算并生成临时结果表,再读取结果写入 AIR 投影。使用前,需要在源数据所属的 catalog 上启用下推,并配置创建临时表所用的写账号及库(Schema)。仅勾选“启用下推”还不够。
准备账号与临时表存放位置
| 配置 | 用途与权限要求 |
|---|---|
| 连接账号 | 用于常规连接和读取;除业务表外,还需能够读取构建过程中生成的临时表 |
| 写账号 | 执行源端计算和建表操作;需能查询视图依赖的业务表,并在指定位置创建、写入和删除临时表 |
| 写入路径(临时表所在库或 Schema) | 预先准备可用的存放位置,并授予所需访问权限。按源数据库填写库名、Schema 名或多级路径 |
两个账号可以按权限设计分别配置;不能将只读连接账号直接当作已具备建表权限的写账号。源端应有足够的临时存储空间,并能承受构建期间的计算和并发读取负载。
开启下推并配置写账号
- 在数据源的“数据连接”中勾选“启用下推”。
- 由具备 catalog 修改权限的管理员配置写账号。DWS 中部分数据源提供独立的写账号配置,例如 Huawei DWS(
HUAWEI_DWS):在“写账号(可选)”中填写用户名、密码和写入路径。写入路径用于指定源端临时表所在库或 Schema。虽然表单标为可选,使用投影下推写入时仍需配置。 - 完成配置并保存后,继续在投影中开启下推写入。
当前仅推荐在 DWS 已提供写账号配置入口的数据源上使用下推写入。未提供该入口的数据源尚未经过充分测试,暂不建议使用此功能。
在投影中启用并验证
- 为该数据源上的逻辑视图创建或编辑投影,在“高级配置”中开启“下推写入”。
- 按需选择自动推荐或手动配置拉取方式;手动配置时指定分批字段和分批数量。
- 执行一次投影构建,检查构建结果、数据行数和查询结果。普通“连通性测试”通过不能代替写账号建表、临时表读取及清理权限的验证。
所有参与计算的数据必须来自同一 catalog,且完整计算逻辑能够下推。具体作用、执行原理和失败排查见投影下推写入。
结果验证
创建后,在数据源目录中检查目标库表与字段,并在工作簿执行查询。例如:
将示例中的目录、库和表名替换为实际名称。若连通性正常但库表不可见,检查连接账号的元数据权限及“元数据同步”范围;若目录可见但查询失败,继续检查数据查询权限和所选版本、兼容模式。